
궁금한 것이 있습니다.
올리신 글을 읽어보았는데요.
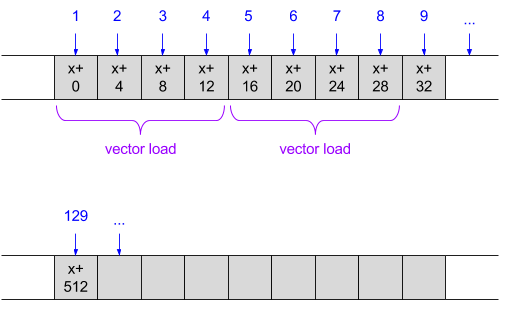
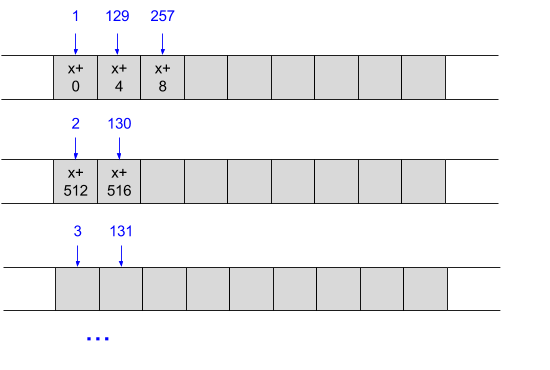
말씀하신 공간 지역성이란게, 컴퓨터의 참조의 지역성을 이용해 캐시메모리를 쓰는 것과 같은 원리인가요??
제가 잘 이해한지 모르겠습니다.
visited[1000][1000][11]의 경우 11 * 1000 의 배열 1000개가 서로 떨어진 공간에 생기고,
visited[11][1000][1000]는 1000 * 1000의 배열이 11개가 서로 떨어진 공간에 생기니,
전자에 경우 계속해서 miss가 나고 매핑을 1000번(극단적으로 볼 경우) 하는 반면,
후자는 11번의 매핑만을 하면되니 속도가 차이 난다. 제가 이해한 것이 맞을까요??
furthermares 3년 전 20
배열의 차원 선언 순서를 한 번 확인해보세요.
visited[1000][1000][11]의 메모리 사용량이 visited[11][1000][1000]의 메모리 사용량의 약 2배 정도입니다.
로직은 맞는데 TLE나 MLE가 나시는 분들은 한번 참고해보세요. 가장 큰 길이의 차원을 가장 오른쪽에 놓는 것이 메모리가 가장 절약됩니다.
이에 대한 이유는 공간지역성과 (Java에서는) 헤더의 수 차이 때문이라고 하네요.
두 방식 모두 AC를 받게 해보면 차이가 이렇게 납니다.
visited[1000][1000][11]: 478536 KB / 6984 ms
visited[11][1000][1000]: 338688 KB / 3812 ms